
Nagios izleme tasarımı: host erişiminden gerçek hizmet kontrolüne
Eski kurulum notlarını güncel izleme mimarisine dönüştürün: güvenli agent, anlamlı eşik ve bağımlılık yönetimi.
Bir sunucunun ping vermesi, üzerindeki iş hizmetinin sağlıklı olduğunu göstermez. Nagios tasarımında host erişimi, yerel kaynak ve uygulama kontrolü farklı katmanlar olarak ele alınır. Çok eski işletim sistemi kurulum notları yeni üretim ortamı için aynen tekrarlanmamalıdır.
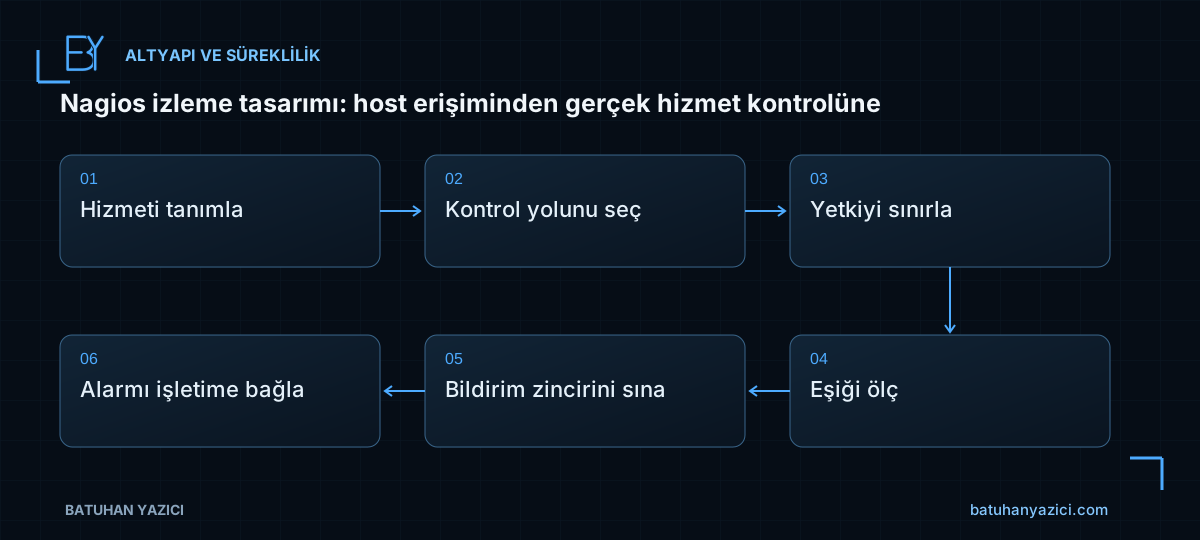
- Hizmeti tanımla
- Kontrol yolunu seç
- Yetkiyi sınırla
- Eşiği ölç
- Bildirim zincirini sına
- Alarmı işletime bağla
İzlenecek işlevi ve sahibi belirleyin
CPU, disk veya bellek ölçümü tek başına kullanıcı deneyimini anlatmaz. HTTP sağlık yanıtı, veritabanı bağlantısı veya kuyruk gecikmesi gibi hizmete özgü kontroller seçilir. Her kontrol için müdahale edecek ekip ve runbook bulunmalıdır.
Aynı soruna onlarca bağımsız alarm üretmek operatörü yorar. Host ve hizmet bağımlılıkları, bakım pencereleri ve planlı kesinti davranışı tasarıma dahil edilir. Alarmın amacı yalnızca kırmızı ekran üretmek değildir.
Agent veya uzak kontrol yöntemini seçin
NRPE, NCPA, check_by_ssh veya pasif sonuç gönderimi farklı seçeneklerdir. Güvenlik, platform desteği, ölçek ve işletim ihtiyacı birlikte değerlendirilir. Eski rehberdeki paket sürümü güncel tercih olarak sunulmamalıdır.
Uzak komut çalıştırma yetkisini daraltın. İzleme hesabının bütün yönetim komutlarını çalıştırması gerekmez. İzinli kaynaklar, şifreli iletişim ve anahtar yönetimi açıkça tanımlanmalıdır.
Plugin sonucunu sözleşme gibi değerlendirin
Kontrolün durum kodu, mesajı ve performans verisi tutarlı olmalıdır. Kontrol komutu çalışamıyorsa bunu sağlıklı değer gibi döndürmemelidir. Timeout ve UNKNOWN davranışı ayrıca sınanır.
Kendi plugin’inizde sırları çıktıya veya işlem argümanına koymayın. Uzun süren sorgular izleme sunucusunu da yorabilir. Kontrol sıklığı uygulama yükü ve tespit gereksinimiyle dengelenmelidir.
Eşiği gerçek temel ölçümden türetin
Her sunucuya aynı CPU veya disk eşiği uygulamak anlamlı olmayabilir. İş yükünün normal döngüsünü ölçün. Yalnızca doluluk yüzdesi yerine büyüme hızı veya kalan alan gibi tamamlayıcı ölçüler gerekebilir.
Retry sayısı ve bildirim gecikmesi geçici dalgalanmayla kalıcı arızayı ayırmaya yardımcı olur. Ancak çok uzun gecikme kritik arızayı saklayabilir. Temsilî hata senaryosunda tespit ve bildirim süresini ölçün.
Bildirim ve toparlanmayı birlikte test edin
Alarmın doğru kişiye ulaştığını ve toparlanma kaydının oluştuğunu doğrulayın. Müdahale edilen olayın neden kapandığı görünür olmalıdır. Düzenli bakımda kullanılmayan kontroller kaldırılır, yeni hizmetler kapsam listesine eklenir.
- Hizmet sahibi ve runbook tanımlı.
- Kontrol yolu en az yetkili.
- Plugin hata durumunu doğru döndürüyor.
- Eşik temel ölçüme dayanıyor.
- Bildirim ve recovery testi başarılı.
İlgili çalışma notları
- Linux LVM disk genişletme: sanal diskten dosya sistemine kadar
- Linux’a yeni disk bağlama: UUID, fstab ve açılış doğrulaması
- Eski CentOS’ta mirror hatası: arşiv deposuyla göç planını karıştırmayın
Kaynaklar ve kapsam
Arşivdeki teknik notlar genel bir laboratuvar anlatımı olarak yeniden düzenlenmiştir. Örnek adlar batuhanyazici.com altında gösterilir; gerçek kurum veya canlı sistem yapılandırması içermez. Komutlar kullanılan ürün sürümü ve yetki kapsamına göre değerlendirilmelidir.
Kıdemli Siber Güvenlik Uzmanı · Altyapı ve güvenlik üzerine teknik notlar.
Okumaya devam edin
WSUS ile kontrollü yama dağıtımı: pilot gruptan doğrulanmış kapanışa
Ürün seçimi, istemci grupları, HTTPS güveni ve yeniden başlatma planıyla WSUS dağıtımını ölçülebilir hale getirin.

Veeam ile sunucu taşıma: VM yedeğinden uygulama kabulüne
Yeni ortama sunucu taşırken uygulama verisi, sertifika, ağ eşleşmesi ve yedekleme yapılandırmasını ayrı planlayın.